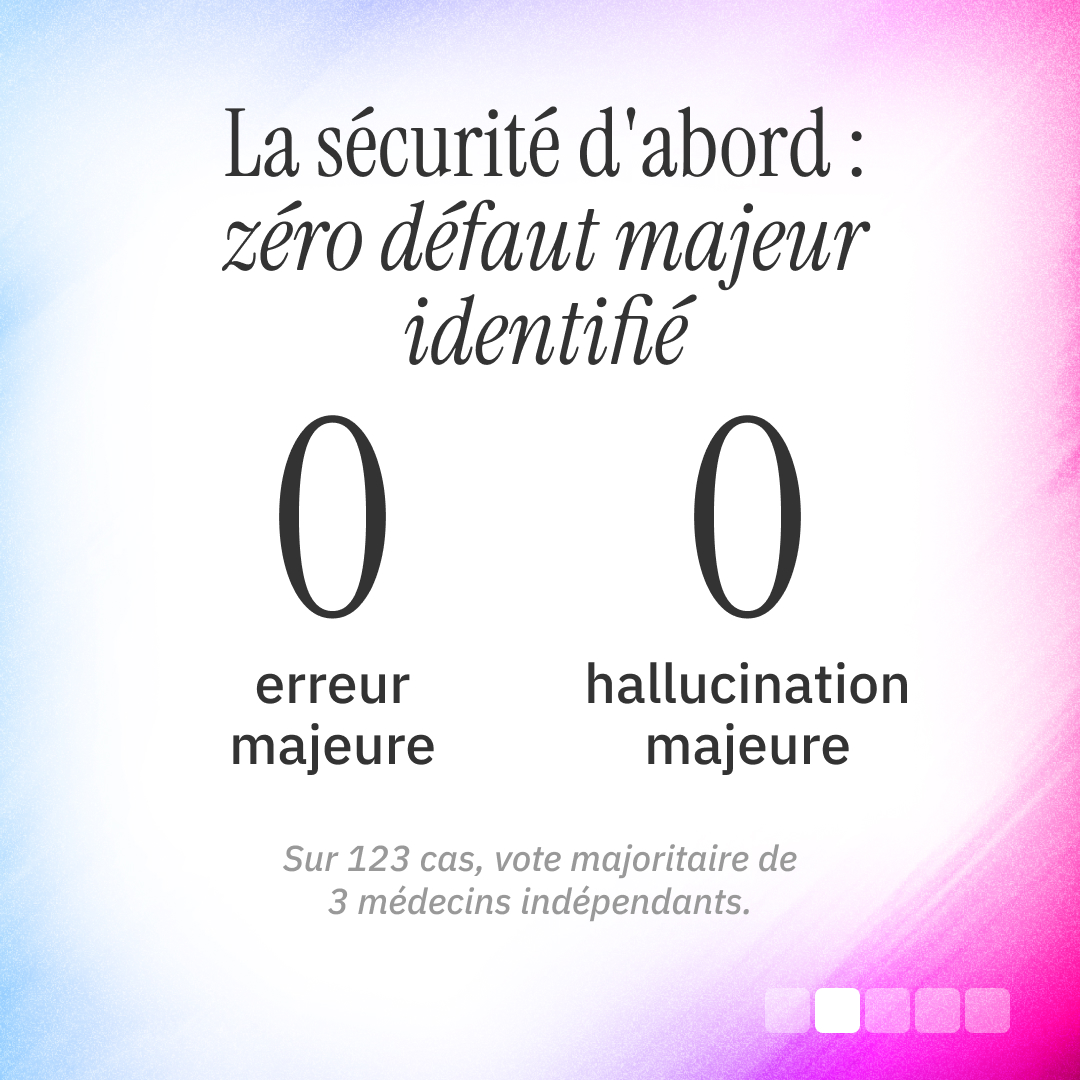
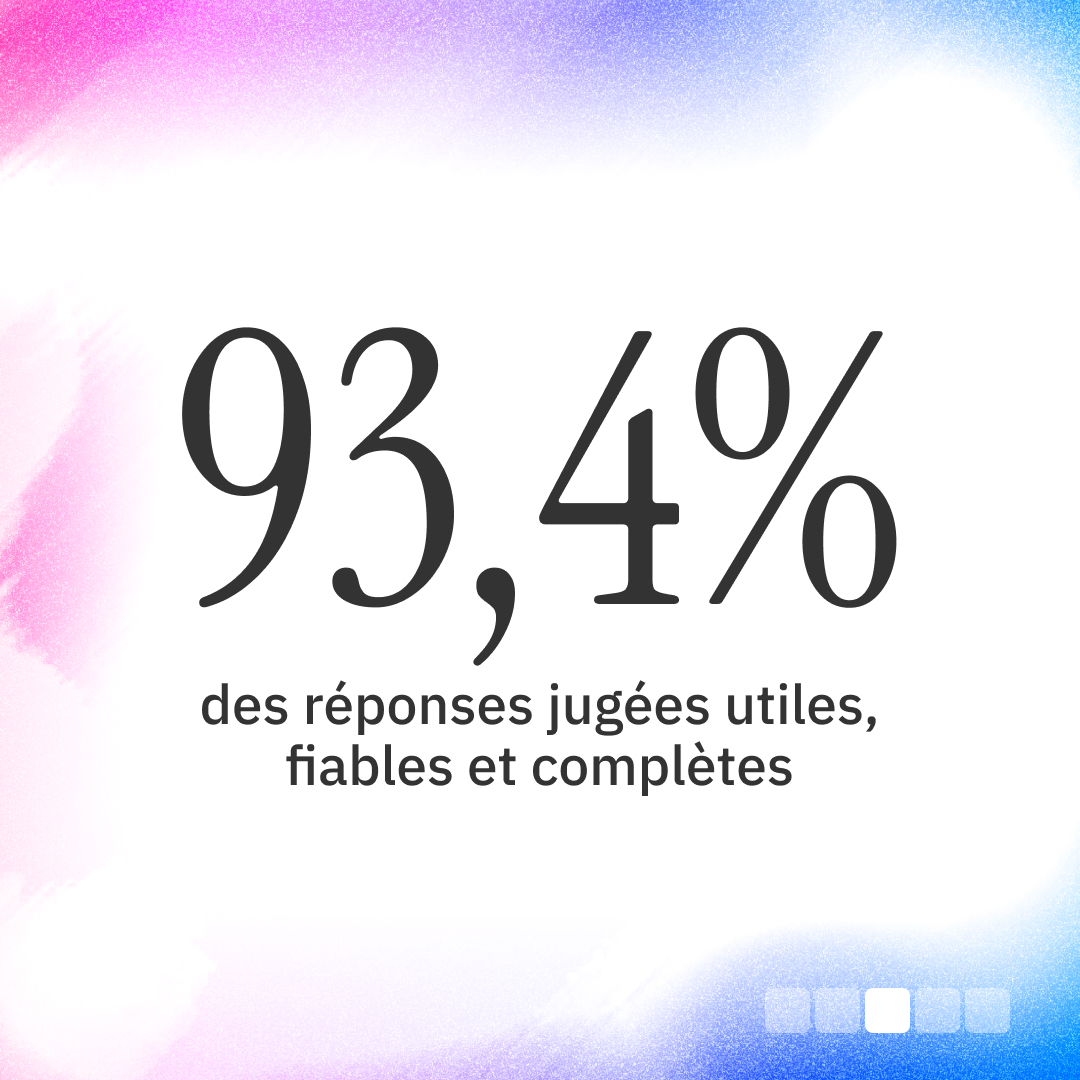
L'étude ASIMOV-Pilot est la première évaluation clinique d'une IA générative en contexte réel réalisée en France. Elle repose sur 123 paires de questions-réponses extraites de l'usage quotidien des professionnels de santé, relues chacune par trois médecins indépendants à l'aveugle. Ces trois experts n'ont identifié aucune erreur majeure, aucune hallucination majeure. Et dans 93,4 % des cas, les réponses ont été jugées utiles, fiables et complètes sur un critère délibérément choisi très strict.
Avant d'intégrer un outil d'IA dans sa pratique, tout professionnel de santé se pose la même question : peut-on lui faire confiance sur de vraies questions cliniques. ASIMOV-Pilot y répond avec des données réelles, évaluées par des médecins indépendants.
Ces résultats préliminaires ont été présentés le 3 juillet au congrès Wonca Europe 2026. L'étude complète sera publiée dans une revue scientifique à l'automne.
Comment l'étude a été conduite
L'étude repose sur des paires de questions-réponses extraites de l'usage réel de MedGPT par des professionnels de santé : des questions anonymisées, posées en conditions réelles, couvrant un large spectre allant de la médecine générale à la cardiologie en passant par la psychiatrie.
Chaque paire a été soumise à trois médecins indépendants en aveugle : le Dr Driss Berdaï, pharmacologue clinicien au CHU de Bordeaux, le Pr Jean-Philippe Joseph, médecin généraliste universitaire au CHU de Bordeaux, et le Dr Pierre-Clément Thiébaud, médecin urgentiste à l'AP-HP. Chacun a évalué chaque cas de façon indépendante, sans connaissance des notes des deux autres, sur plusieurs dimensions : l'utilité clinique globale de la réponse, sa complétude, l'actualité des connaissances mobilisées, la pertinence des références citées, et la présence d'éventuelles erreurs ou hallucinations.
Le critère d'acceptabilité combinait trois exigences simultanées : une utilité clinique jugée bonne ou excellente, aucune erreur majeure, aucune hallucination majeure. Un seuil volontairement exigeant : une réponse n'est jugée acceptable que si elle satisfait les trois conditions à la fois.
Au total et à date, 369 évaluations individuelles ont été produites. Les résultats ont été agrégés cas par cas, par vote majoritaire des trois relecteurs.
Les résultats
Sur la sécurité des réponses, le résultat est sans ambiguïté : aucune erreur majeure, aucune hallucination majeure n'a été identifiée par vote majoritaire sur l'ensemble des 123 cas. C'est dans ce cadre que s'inscrit le résultat : 93,4 % des réponses ont été jugées utiles, fiables et complètes (IC 95 % : 87,6 à 96,6 %).
Que représentent les 6,6 % restants ?
Les 6,6 % restants ne sont pas des réponses fausses ou dangereuses. Ce sont des réponses jugées incomplètes, d'une utilité clinique moins probante, ou comportant une erreur mineure ou modérée, sans jamais atteindre le seuil d'une erreur ou d'une hallucination majeure : la sécurité reste à 100 %. Ces réponses ne sont aucunement fausses ou dangereuses, ce sont des réponses imparfaites.
Les résultats secondaires vont dans le même sens : 100 % des réponses ont été jugées à jour, et les trois relecteurs étaient d'accord dans 87 % des cas sur l'évaluation globale, un niveau de concordance élevé pour une évaluation subjective par des cliniciens.
Ce que ça change pour la pratique
ASIMOV-Pilot apporte une réponse concrète à la question de confiance : sur de vraies questions cliniques évaluées par de vrais médecins, aucune erreur ou hallucination majeure n'a été identifiée et 93,4 % des réponses ont été jugées utiles, fiables et complètes.
Pour un professionnel de santé, ça change la nature de la question. Ce n'est plus "cet outil peut-il se tromper", puisque tout outil peut se tromper, tout clinicien aussi. C'est "MedGPT permet-il d'aller plus vite, de mieux sourcer, de vérifier rapidement une information en consultation". Les résultats suggèrent que oui, avec une précision essentielle : MedGPT est un outil d'aide à la décision, pas un outil de décision. La réponse qu'il génère est un point d'appui, pas une conclusion.
L'étude pointe aussi un second enseignement pour la pratique : quand les réponses ne sont pas à la hauteur, c'est souvent parce que la question posée à l'outil est mal formulée. Une IA médicale n'est jamais meilleure que la question qu'on lui soumet, et apprendre à bien l'interroger fait partie de l'usage.
Ce que l'étude ne mesure pas encore
ASIMOV-Pilot est une première étape, dont les limites sont assumées. L'étude a été conduite dans le contexte médical français, sur des questions posées par des professionnels de santé utilisant MedGPT : elle ne dit rien des performances de l'outil dans d'autres contextes, d'autres langues ou d'autres systèmes de santé.
Elle ne mesure pas non plus l'impact réel sur les patients : savoir qu'une réponse est jugée utile et complète par des médecins experts ne dit pas si elle a changé une décision clinique ou évité une erreur en aval, ce qui fera l'objet d'une seconde étude prospective. Enfin, ASIMOV-Pilot n'est pas une étude comparative : elle évalue MedGPT sur ses propres mérites, sans le confronter à d'autres outils du marché. Le benchmark complet de MedGPT face aux IA généralistes apporte cet élément de comparaison, sur un protocole différent.
L'étude complète sera soumise à une revue scientifique à l'automne, sur un échantillon finalisé de 150 cas, avec une publication en accès ouvert.
Ce qu'il faut retenir
Sur 123 questions cliniques réelles, évaluées par trois médecins indépendants, aucune erreur ni hallucination majeure n'a été identifiée, et 94 % des réponses ont été jugées utiles, fiables et complètes. C'est une première preuve solide, avec des limites clairement posées, dans l'attente d'une publication scientifique complète à l'automne. Elle vient compléter les résultats de MedGPT aux Épreuves Classantes Nationales 2023, une preuve théorique obtenue sur un tout autre terrain.
Pour aller plus loin